具身模型的感知、决策与操作能力正在快速提升。但进入真实物理世界后,却仍可能因为未曾见过的物体位姿、环境扰动或长序列累积误差而出现动作偏差,导致分布外 (OOD) 任务成功率降低。受端到端模型黑箱特性的长期制约,传统方案通常只能采用“重新采集示教数据,并对庞大的模型进行微调重训”的纠偏方式。不仅时间与算力成本高昂,且难以解释并根除失败的深层机理。极智嘉具身智能在 Gravity 框架下创新探索 Gravity Control 因果干预模型,展现出业内领先的自然语言运行时纠偏能力:无需训练原始策略模型、无需新增示教数据,通过机制可解释性挖掘模型内部的动作调控机制,并在推理阶段直接干预相关 latent feature,实现具身策略的运行时纠偏。Gravity Control 从揭示端到端模型内部的因果表征机制入手,建立“概念可解释+行为可控制”的双向闭环。操作人员仅凭一句自然语言提示,便能精确激活与微调模型深层的运动特征,成功将分布外(OOD)复杂操作任务的成功率从17.5%大幅提升至87.5%,单项设置的成功率更是由5%飙升至 95%。核心问题:“有概念”不等于“具因果”
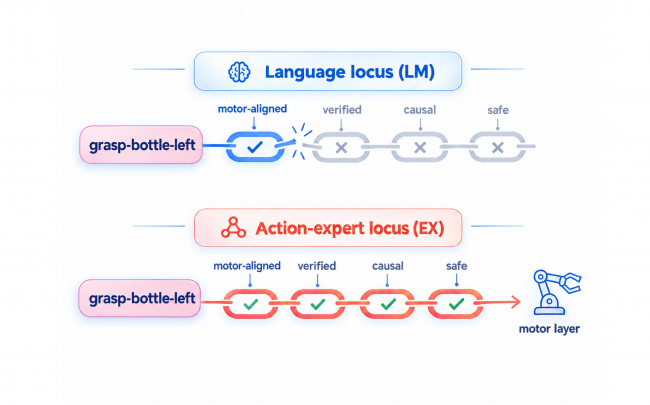
要实现运行时纠偏,首先需要回答一个底层问题:模型内部大量 latent representations 中,哪些才真正拥有动作控制权?学界通常认为,如果一个神经元或表征能被解码出某种语义概念,它就必定在指导机器人的行为。但极智嘉具身智能研究发现,相关性不等于因果性(Not all concepts are causal)。在大多数具身智能模型的骨干网络中,许多对特定物体或指令高度敏感的语言层表征,本质上只是对文本prompt或视觉场景的被动“语义描述”。而真正驱动末端执行器姿态、夹爪开合以及位移速度的“因果运动控制层(MotorLayer)”,高度集中在动作生成链路的动作专家(ActionExpert)深层。
为厘清内部表征的作用路径,极智嘉研发团队形式化定义了一条概念属性链(Concept Property Chain),并依次验证 Faithful 保真性 → Motor Aligned 运动对齐 → Verified 泛化验证 →Causal 因果可控 → Safe 闭环安全。实验揭示,语言层特征往往在运动对齐或泛化验证阶段中断。其特征名看似指向运动,实则无法干预物理动作;唯有动作专家层能完整走通整条属性链。
Gravity Control:找到模型内部真正可控的 Control Handles
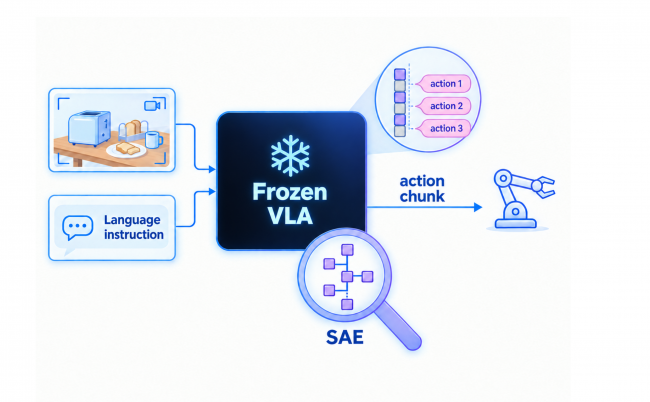
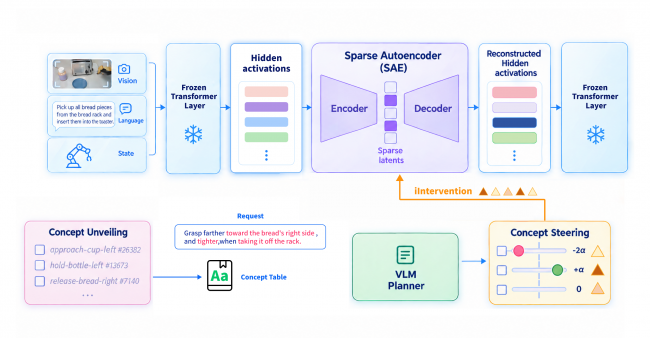
为系统分析模型内部的动作表征,极智嘉具身智能构建了 Gravity Control 模型:
Gravity Control 模型框架总览首先,在冻结原始模型骨干的前提下,Gravity Control 在 Residual Stream 中引入 Top-k SAE 等技术模块,对高维 Hidden Activations 进行稀疏特征分解(Sparse Feature Discovery),从中提取具有可解释语义的 latent features。随后,通过定向因果干预(Causal Intervention),对已完成语义标注的 latent feature 进行 amplification / suppression,并观测位置、旋转、夹爪等动作通道的响应。为了验证干预是否只作用于目标动作,而非同时扰动其他自由度,研究进一步引入干预特异性评估(Specificity Ratio),筛选方向一致、剂量响应单调、对目标动作影响较集中的Control Handle。
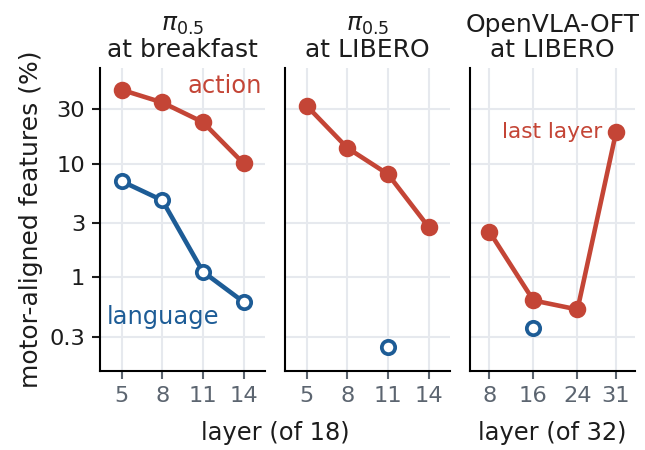
π0.5与OpenVLA-OFT在不同层插入SAE后得到的可用特征数量比例区别相较于仅通过 feature activation 对模型内部进行“readout”,这一架构进一步建立了从Interpretability → Intervention → Control 的闭环。以自然语言,直接纠偏底层动作
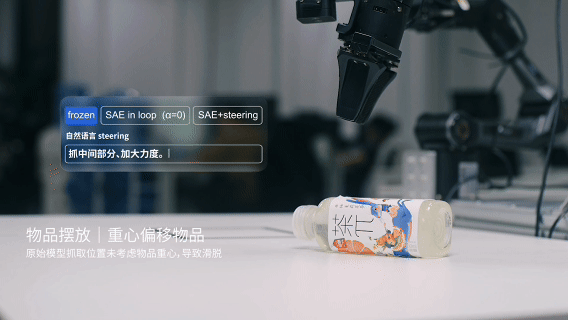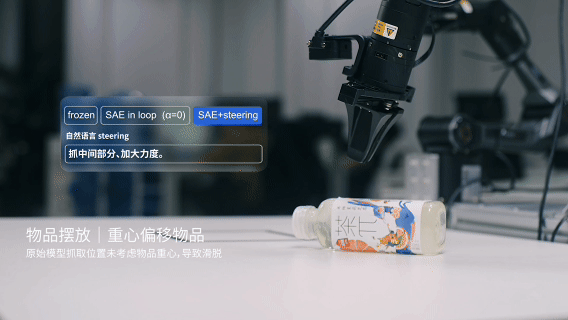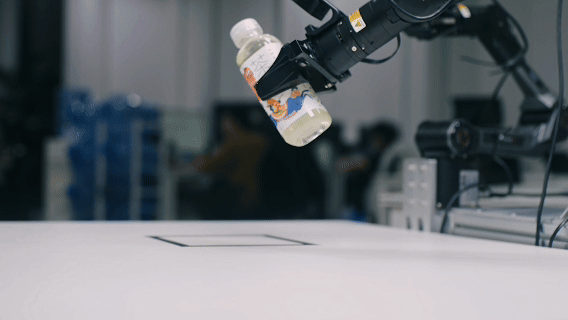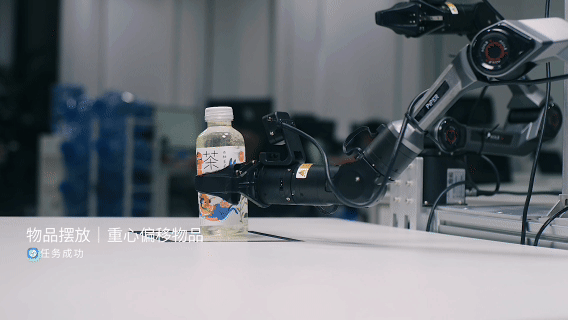
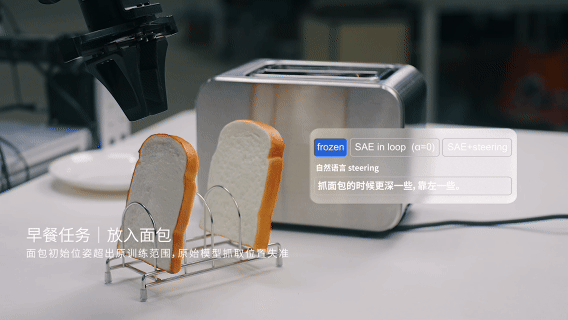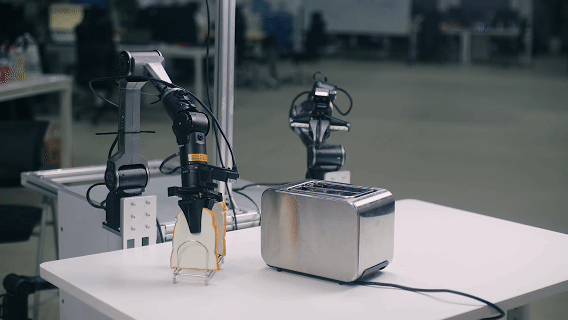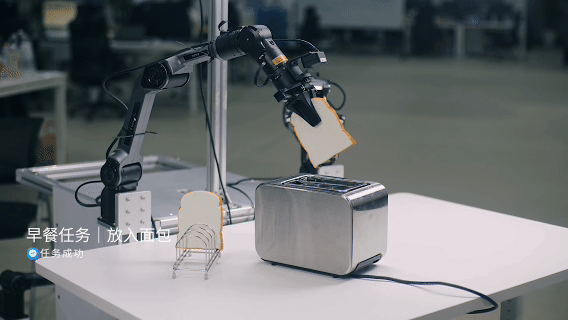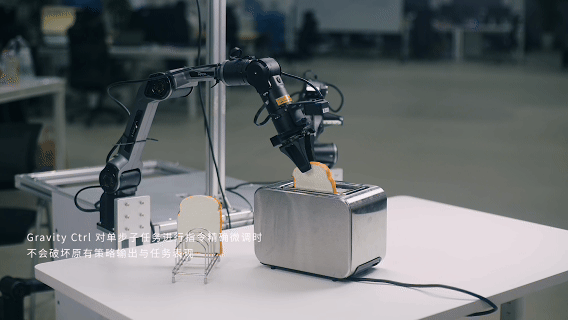
在完成 causal feature identification 之后,Gravity Control 进一步解决了一个更具工程意义的问题:如何让人以自然语言方式调用这些底层 Control Handles?传统的端到端模型只接受宏观任务级指令(如“将面包放入盘中”),一旦执行过程遇到微小几何偏差,上层语言指令无法传递精细的抓取深度、左臂手腕翻转角、夹爪开度等底层控制参数。基于已建立的概念控制表,Gravity Control 构建了语言引导的动作调节链路。当机器人出现动作偏差,操作人员可发出自然语言提示(如“下夹取时抓得更深一点、更低一点”)。外部VLM规划器无需重新规划轨迹,而是检索概念表中的特征词表,对原始模型内部 activation 进行在线 steering。
与重新规划整条 trajectory 不同,这一路径直接干预模型内部已经学习到的 primitive motor representation。同时,Closed-loop Gate 用于限制最大 intervention dose,确保干预仅改变特定几何自由度,而不引发灾难性动作发散。
Gravity Control 的关键并不是“机器人听懂一句话”,而是让 correction intent 可以低成本地映射为模型内部可验证、可约束的 runtime control。实验验证:可解释性与零微调OOD任务提升
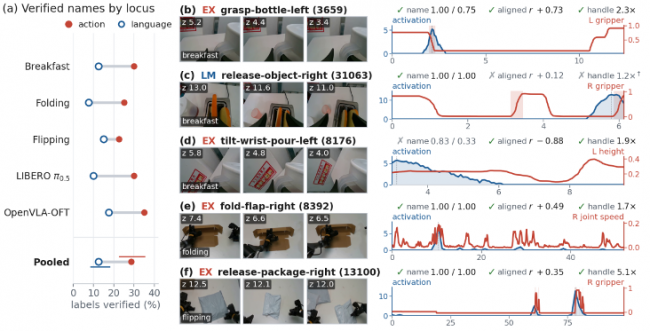
Gravity Control 模型不绑定某一种具身策略架构,接入不同类型的原始模型均可实现以自然语言进行运行时纠偏,大幅提升OOD任务成功率。当前,Gravity Control 模型已在 π0.5、OpenVLA-OFT 等代表性 VLA 架构、LIBERO simulation benchmark 以及物理机器人平台上进行了全面评估:实验首先验证了 Naming 与 Control 之间的差异。汇总多个策略后,部分具有可靠语义名称的 feature 最终并不能通过因果干预测试;反之,能否真正成为 Control Handle,取决于 intervention 对 physical action 的实际影响,而非 feature 名称本身。动作侧可验证、与运动对齐的特征也整体明显多于语言侧。
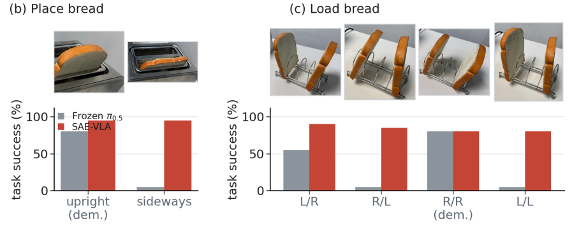
概念命名与动作因果控制相脱节 Naming and control come apart 现象在真实机器人 OOD 任务中,在不更新原始策略模型权重、不新增机器人示教数据的前提下,该架构成功将横放面包等分布外失败任务的整体成功率从 17.5% 跃升至 87.5%,实现了即插即用的零样本动作挽救。其中,横放面包这一单项 OOD setting 的成功率由5% 升至 95%。
利用自然语言在线纠偏真实机器人的完整工作流这表明 Gravity Control 的目标并非单纯“把动作推向某个方向”,而是在 base policy 已具备基础 任务能力的前提下,通过经验证的 latent intervention 实现 zero-finetuning failure recovery,同时约束对原策略的副作用。从 Correction 到 Skill:让纠错成为自进化的起点
随着各种端到端具身智能模型从 benchmark 逐渐进入真实物理环境,模型能力本身已不再是唯一需要关注的问题。更重要的是:当机器人出现失误时,是否能够诊断问题来自哪里,并对局部行为进行可预测、可约束的干预。Gravity Control 可以进一步接入更上一级的 Agent 或 AI原生系统套件,由上层系统持续判断任务状态、识别动作是否偏离目标,并自动完成Detect → Diagnose → Correct的全流程作业链条。不必由人担任机器人的“监督员”,而是由系统在局部错误进一步累积前,主动调用 Gravity Control。更进一步,一次成功的 correction 也不必是一次性的。系统可以记录当时的 task phase、scene / state、被调用的 Control Handle、intervention dose 与执行结果,将成功的纠偏过程沉淀为可复用的 Skill。下一次遇到相似状态时,系统即可优先检索并调用既有经验,进一步降低对人工干预的依赖。这意味着 Gravity Control 的长期价值不仅是让机器人“更容易被纠正”,而是让一次纠错逐步变成可以积累、复用的经验。从 Correction 到 Skill 再到 Self-evolution,Gravity Control 为具身系统持续减少人工介入、走向自主纠错与能力自进化提供新的技术路径。
|
版权声明:本文版权为第一机器人网(www.d1robot.com)所有,原文链接:https://www.d1robot.com/thread-354-1-1.html





 发表于: